Daten verbinden.
Prozesse automatisieren.
Anwendungen bauen.
Datenmonster ist die Low-Code-Plattform für Datenintegration und Automatisierung. Verbinde Datenbanken, Dateien und APIs, transformiere Daten visuell, automatisiere Abläufe und mach daraus Formulare, Dashboards und fertige Datenanwendungen – auf deinem eigenen Server.
- ✓Self-Hosted
- ✓Low-Code
- ✓KI lokal oder Datenmonster AI
- ✓Docker
- ✓Pluginfähig

Mehr aus JTL machen – ohne die Wawi zu verbiegen.
Nutze deine JTL-Daten für Auswertungen, Meldungen, Automatisierungen und eigene Anwendungen. Mit fertigen Templates startest du sofort – oder baust dir deine Lösung visuell selbst.
- ✓Acht fertige Module, erhältlich über MonsterSuite
- ✓Cockpits für Geschäftsführung, Vertrieb, Einkauf und Versand
- ✓Intrastat-Meldungen und Stammdaten-Health-Check
- ✓Direkt auf der JTL-Datenbank, ohne Zwischenschicht
Drei Dinge, die zusammengehören.
Die meisten Werkzeuge decken einen dieser Schritte ab. Datenmonster deckt alle drei ab – deshalb bleibt der Weg von der Datenquelle zur fertigen Anwendung in einem System.
Daten integrieren
Datenbanken, Excel, CSV, XML, JSON, Access, Parquet, REST-APIs, FTP/SFTP, IMAP und Webseiten verbinden – lesend wie schreibend.
Prozesse automatisieren
Daten transformieren, zusammenführen und prüfen. Abläufe in Pipelines verketten und per Zeitplan ausführen lassen.
Anwendungen bauen
Formulare, Dashboards und fertige Datenanwendungen erstellen, damit Endanwender den technischen Unterbau nicht kennen müssen.
Vom Datenimport bis zur fertigen Anwendung – in einer Plattform.
Mehr als ETL.
ETL beschreibt die ersten beiden Schritte. Bei Datenmonster hört es dort nicht auf.
- Quellen
- JTL
- SQL
- Excel
- CSV
- Access
- REST
- FTP
- Verarbeiten
- Mapping
- JOIN
- Transformation
- Datenqualität
- KI
- Automatisieren
- Pipelines
- Zeitplan
- Bedingungen
- Aktionen
- Anwendung
- Formular
- Dashboard
- Export
- API
Aus Datenprozessen werden Anwendungen.
Erstelle Eingabemasken und verbinde sie direkt mit deinen Datenprozessen. Anwender geben nur ein, was gebraucht wird – Abfragen, Transformationen, Exporte und Automatisierungen laufen im Hintergrund.
- 1Formular
- 2Parameter
- 3Mapping
- 4Datenbank
- 5Ergebnis
Genau das unterscheidet Datenmonster von klassischen ETL- und Reporting-Werkzeugen: Am Ende steht nicht ein Report, sondern eine Anwendung, die jemand bedienen kann.
Sieh selbst,
wie es funktioniert.
Visueller Mapping Editor
Verbinde Datenquellen per Drag & Drop. JOIN-, Transform-, Calc-, SQL-, Aggregation- und Lookup-Nodes ermöglichen komplexe Transformationen ohne eine einzige Zeile Code.

Dataset-Verwaltung
Alle Datenquellen auf einen Blick. Kacheln zeigen Zeilenanzahl, Spalten und letzten Refresh. Der DataExplorer ermöglicht tabellarische Ansicht mit Suche und Paginierung.

Database Analyzer
Interaktives ER-Diagramm für alle verbundenen Datenbanken. Explizite und implizite Beziehungen werden automatisch erkannt. Per Klick Dataset-Import direkt aus dem Diagramm.

Pipeline Editor
Automatisiere komplexe Workflows mit dem visuellen Pipeline Editor. Trigger-, Mapping- und Bedingungsknoten ermöglichen zeitgesteuerte und ereignisbasierte Ausführung.

KI, die deinen Datenprozess versteht.
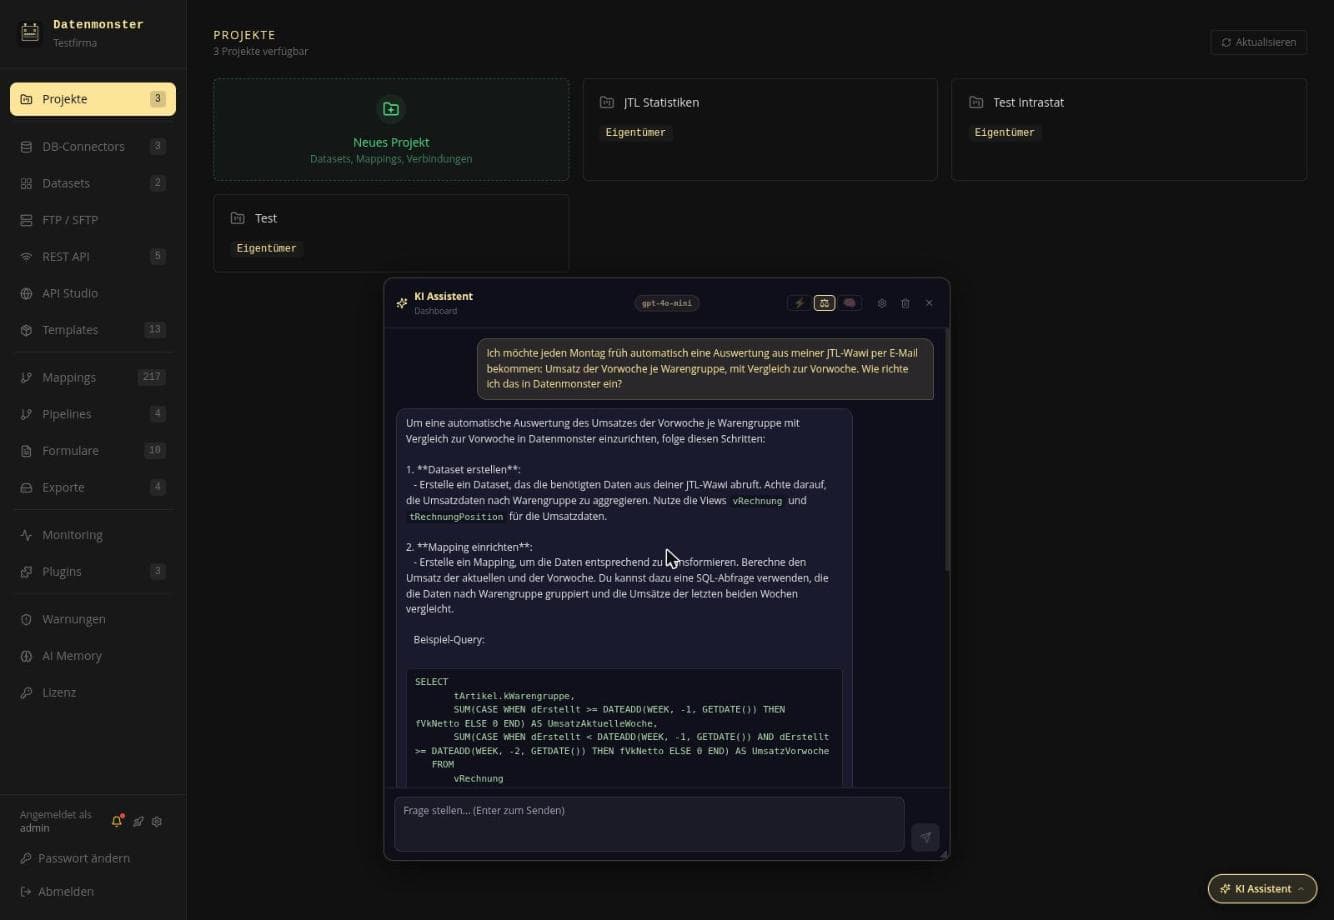
Der Assistent kennt deine Verbindungen, Tabellen, Nodes und Prozesse. Statt allgemeiner Antworten bekommst du Vorschläge, die zu deinen Daten passen.
- „Erstelle mir ein Mapping, das alle Kunden ohne Bestellung in den letzten 90 Tagen ermittelt."
- „Warum schlägt dieses Mapping fehl?"
- „Erstelle eine SQL-Abfrage für Umsatz pro Kunde."
Lokal oder Datenmonster AI – du entscheidest.
Datenmonster bringt ein lokales Sprachmodell mit (Ollama): Deine Schemas, Kunden- und Umsatzdaten verlassen deinen Server nicht. Wer mehr Leistung ohne eigene Hardware will, schaltet auf Datenmonster AI um – leistungsstarke Modelle (GPT-4o) ohne eigenen OpenAI-Account, abgerechnet über Credits in MonsterSuite. Prompts und Antworten speichern wir dabei nicht. Umschalten geht jederzeit in den Einstellungen.
Nicht bei Null anfangen.
Templates sind fertige Lösungen für konkrete Aufgaben: Datasets, Mappings, Pipelines und Formulare in einem Paket. Installieren, Datenbankverbindung wählen, fertig. Erworben werden sie über MonsterSuite.
Intrastat für JTL
Meldedateien für eSTATISTIK.core und Destatis-CSV direkt aus den Wawi-Daten – Ausfuhr und Einfuhr, mit monatlichen Pipelines.
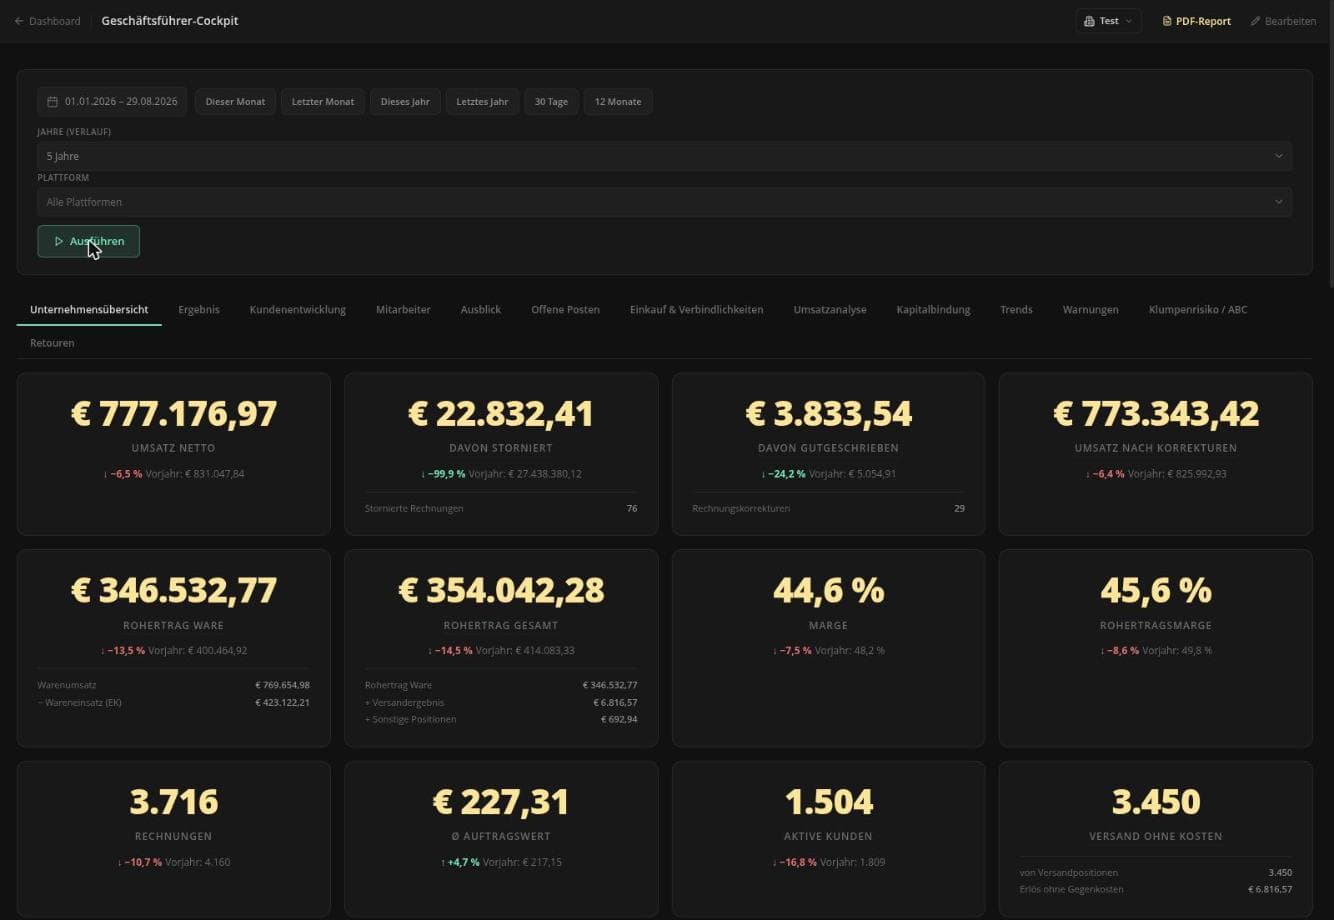
Geschäftsführer-Cockpit für JTL
Umsatz, Kunden, Kapitalbindung und – mit den eigenen Fixkosten – das Betriebsergebnis, alles mit Vorjahresvergleich. Aus 67 Mappings, ohne eine Zeile SQL.
Weitere Templates folgen. Nach dem gleichen Prinzip lassen sich Lösungen für andere Systeme bauen.
Datenmonster wächst mit deinen Anforderungen.
Plugins ergänzen Datenquellen, Zielsysteme und Fachfunktionen, ohne den Kern aufzublähen. Neue Plugins installierst du per Datei-Upload.
- eSTATISTIK.core
- Mail / IMAP
- Web / HTML
- MongoDB
- REST
- Faker
REST API Studio
APIs testen, verstehen, integrieren – und aus einer Abfrage einen eigenen Endpunkt erzeugen. In Arbeit, noch nicht Bestandteil der aktuellen Version.
Deine Daten. Deine Infrastruktur.
Datenmonster läuft per Docker Compose auf deinem Server. Es gibt keine zentrale Cloud, in die deine Unternehmensdaten übertragen werden müssten.
Docker Compose
Ein Befehl installiert und startet den kompletten Verbund.
Verschlüsselte Zugangsdaten
Datenbank-Passwörter werden verschlüsselt gespeichert.
Benutzer und Rollen
Mehrere Projekte, Rollen und Freigaben pro Benutzer.
Nachvollziehbar
System-Log, Ausführungshistorie und Monitoring im Blick.
Alles was du brauchst,
in einem Tool.
Von einfachen Datei-Importen bis zu komplexen mehrstufigen ETL-Pipelines mit Scheduling, Formularen und KI-Assistent.
Fair. Transparent.
Skalierbar.
Starte kostenlos und erweitere wenn du bereit bist. Keine versteckten Kosten.
Zum Testen und für kleine Community-Projekte.
- ✓1 Projekt
- ✓Bis zu 3 Mappings
- ✓CSV & Excel Import
- ✓1 Datenbankverbindung
- ✓Community-Support
- –Kein Scheduler
- –Kein FTP/SFTP
- –Keine REST API
- –Kein Database Analyzer
Für professionelle Nutzer mit vollem Funktionsumfang.
- ✓Unbegrenzte Projekte
- ✓Unbegrenzte Mappings
- ✓Alle Datenquellen
- ✓Unbegrenzte Verbindungen
- ✓Scheduler & Automatisierung
- ✓REST API Integration
- ✓Pipelines
- ✓Database Analyzer mit ER-Diagramm
- ✓Priority-Support
Alle Preise zzgl. gesetzlicher MwSt. · Keine automatische Verlängerung
Ein Befehl,
und es läuft.
Datenmonster läuft per Docker Compose auf deiner eigenen Infrastruktur. Das Skript prüft die Voraussetzungen, installiert Docker bei Bedarf und startet alles.
$ curl -fsSL https://raw.githubusercontent.com/choldermann/datenmonster/main/install.sh | bashDanach erreichbar unter http://localhost:5174
Voraussetzungen: Docker Engine 20.10+ und Docker Compose v2. Windows über Docker Desktop mit WSL2.